Rubyの正規表現でネストしたカッコに対応するには
- 新規公開
- 最終更新
ネストしない表現
例えばMarkdownでブログを書き,書いた記事にrubyのスクリプトで正規表現を使った処理をしなければならないとする。
次の記事からリンク部分だけををマッチするにはどうすればいいか?
## リンク集

 - [リンクその1](https://example.com/link1)

 - [リンクその2](https://example.com/link2)

 - [リンクその3](https://example.com/link3)
最も簡単な方法のうちのひとつはこれ:
/\[[^\]]+\]\([^\)\s]+\)/順に読み解くと次の要素に分解できる:
始め角括弧
終わり角括弧以外の文字列
終わり角括弧
始め丸括弧
終わり丸括弧と空白文字以外の文字列
終わり丸括弧
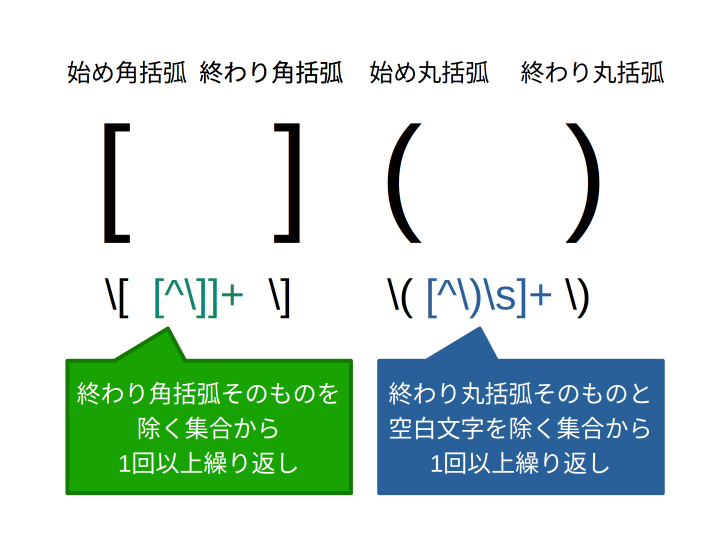
さらにタイトル部分とリンク部分に丸括弧を足せばキャプチャグループを作ることもできる。
/\[([^\]]+)\]\(([^\)\s]+)\)/こうすると$1,$2という特殊変数を使ってタイトルとURLをそれぞれ取り出すことができる。
シンプルイズベスト。大体のシチュエーションにおいてはこの程度のパターンで十分である。一部の迷惑なサイトを除いて……
ネストする表現
上記のパターンではタイトルの中に「終わり角括弧」が出現することを想定していない。
しかし,実際にはタイトルの中に「終わり角括弧」が出現するという状況は結構ある1。
## リンク集

 - [リンクその[1]](https://example.com/link1)

 - [リンクその[2][前半]](https://example.com/link2(2))

- [リンクその[3][後半[随時更新]]](https://example.com/link3((3)))Markdownを正規表現で処理するものとしては迷惑この上ないが,正規表現にマッチできないパターンはない。
部分式呼び出し
rubyの正規表現には通常の正規表現にはない再帰的記述を可能にする部分式呼び出しという機能がある。これを使えばネストした括弧もマッチできる。複雑になるので改行を入れて表現した。
(?<brackets>
    \[
        (?: [^\[\]]+ | \g<brackets> )*
    \]
)
(?<parentheses>
    \(
        (?: [^\(\)]+ | \g<parentheses> )*
    \)
)\g<name>という記法を使うと,nameという名前がつけられた部分正規表現にマッチしようとする。また(?: pat )という記法はキャプチャしないグループを作り,一つのかたまりとしてマッチできる。リンクの側もタイトルと同様にURL内に丸括弧が出現する状況にも対応してみた。
これで解決だ!と思うかもしれないが,残念ながらこのパターンには致命的な誤りがある。再帰的処理の停止条件が不十分なため無限バックトラック(マッチ再試行)が発生してしまうのだ。これは「キャプチャしないグループ」内でマッチしなかったとしても部分正規表現にマッチするかどうか調べに行ってしまうことにより発生する。
これを停止するためには「この部分でマッチしなければ諦める」という停止条件を再帰的処理の中に含めなければならない。
アトミックグループ
Rubyの正規表現にはアトミックグループというバックトラックを抑制するための機能がある。アトミックグループ内でマッチしたあと,後続の式がマッチに失敗した場合このグループのマッチ全体を巻き戻す,すなわち「このグループにマッチしなければ諦める」という動きをする。
タイトル部分とリンク部分をそれぞれ別のアトミックグループにすればより安定したマッチができる。
(?<title>
    \[
        (?>
            (?: [^\[\]]+ | \g<title> )*
        )
    \]
)
(?<link>
    \(
        (?>
            (?: [^\(\)]+ | \g<link> )*
        )
    \)
)
これは再帰呼出しそのものが自己完結的なので,複数のネストや深いネストの場合でも問題なくマッチできる。シンプルにリンクだけ取り出す必要があるのならこのパターンを使うのが良いだろう。
正規表現はいくらでも難しく書くことができるので,使う人にとって理解可能な複雑さであることが重要だ。
他にも書きようはあるはずだが,ほどほどにしておかないと人間には理解不能な代物になってしまう。
参考
現実的には括弧が閉じているとも限らないのだが,その場合Markdownとして正しく処理できないはずなのでこの記事では扱わない。↩︎
ライセンス情報

Rubyの正規表現でネストしたカッコに対応するにははクリエイティブ・コモンズ [表示 4.0 国際]ライセンスの下に提供されています。